
【導(dǎo)讀】今天,英特爾在廣州辦了一場AIGC創(chuàng)作研討會,主題叫“智算于芯,創(chuàng)想無垠”。會上重點(diǎn)展示的是一套基于銳炫Pro B70專業(yè)顯卡的本地AI視頻制作全流程方案,合作方是MiniMax和數(shù)字折疊。眼下AI視頻生成是國內(nèi)AIGC賽道里最熱的方向之一,AI短劇也在快速起量,但問題也很現(xiàn)實(shí)——云端算力貴、部署門檻高,中小團(tuán)隊(duì)和個(gè)人創(chuàng)作者很難吃得消。英特爾這次主打的邏輯很清楚:用本地算力替代云端依賴,降低制作成本,同時(shí)把模型適配和軟件工作流打通。32GB大顯存、367 TOPS算力、開源模型MiniMax H3的首發(fā)適配,再加上數(shù)字折疊那邊壓縮到3個(gè)核心節(jié)點(diǎn)的無限畫布工作流——從硬件到軟件,英特爾試圖給創(chuàng)作者提供一套開箱即用的本地化解決方案。
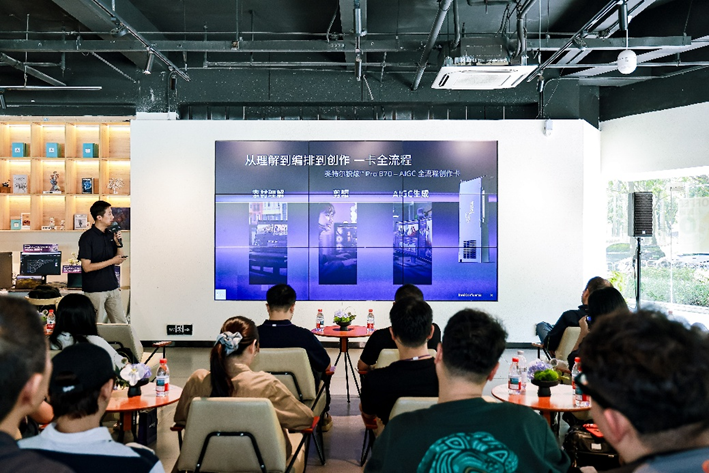
當(dāng)前,國內(nèi)AIGC產(chǎn)業(yè)迎來爆發(fā)式的繁榮發(fā)展,圖像與視頻生成更是增長極為迅猛的核心賽道。但在AI短劇快速崛起的背后,市場不僅對角色一致性、音畫質(zhì)量及鏡頭的動態(tài)連貫性提出了影音級別的高要求,昂貴的算力與復(fù)雜的部署更讓大量中小型團(tuán)隊(duì)和個(gè)人創(chuàng)作者望而卻步。與此同時(shí),技術(shù)能力向少數(shù)閉源模型的過度集中,也讓創(chuàng)意表達(dá)難以充分施展。
英特爾軟件工程副總裁、端側(cè)AI與圖形卓越中心負(fù)責(zé)人熊悅表示:“AIGC正在重塑影視行業(yè)內(nèi)容創(chuàng)作的生產(chǎn)方式,如何在有限的預(yù)算內(nèi)將優(yōu)秀創(chuàng)意轉(zhuǎn)化為高品質(zhì)成品,成為了AI短劇行業(yè)破局的關(guān)鍵所在。英特爾攜手廣泛的生態(tài)合作伙伴,通過構(gòu)建開放、靈活、高效的算力平臺,全面適配多元AI場景,為本地AI視頻生產(chǎn)提供兼具靈活性與成本優(yōu)勢的生產(chǎn)力平臺和解決方案,讓創(chuàng)意快速落地,把真正的創(chuàng)作自由交還給每一位創(chuàng)作者。”
銳炫Pro B70,以本地算力支持視頻制作全流程
作為生產(chǎn)力級別智能體推理卡,英特爾銳炫Pro B70專業(yè)級顯卡為專業(yè)設(shè)計(jì)與AI創(chuàng)作而生,集32GB大顯存、367 TOPS算力、硬件級編解碼能力與AI加速引擎于一體。依托強(qiáng)大的本地算力與顯存優(yōu)勢,銳炫Pro B70能進(jìn)一步提升模型加載與采樣效率,穩(wěn)定運(yùn)行從劇本創(chuàng)意、素材生成、視頻剪輯、配音配樂到成片交付的AIGC全流程創(chuàng)作。在AI漫劇等新興場景中,銳炫Pro B70貫穿本地生成、超分、資產(chǎn)整理與剪輯全流程,全面支持智能體驅(qū)動的AI創(chuàng)作新范式:
VLM多媒體資產(chǎn)智能整理:利用英特爾多模態(tài)能力與銳炫Pro B70的本地算力,完成從“視頻硬件解碼—智能分段—采樣/片段—高并發(fā)VLM加速—總結(jié)報(bào)告”的完整鏈路,支持對多媒體素材進(jìn)行自動標(biāo)定與歸類,并提供本地語義檢索功能,顯著提升劇本與素材整理效率。
專業(yè)級剪輯性能:搭載雙路硬件編解碼單元,支持8K@120Hz、HDR等格式,可流暢剪輯10軌以上4K視頻;此外還針對剪映、DaVinci Resolve、Adobe Premiere Pro及Photoshop等專業(yè)后期軟件進(jìn)行了適配與優(yōu)化,帶來極為流暢的專業(yè)創(chuàng)作體驗(yàn)。
高效AI生圖與生視頻:銳炫Pro B70第一時(shí)間完成對開源模型MiniMax H3的Day 0適配,并持續(xù)進(jìn)行軟件優(yōu)化。基于32GB大顯存與性價(jià)比優(yōu)勢,英特爾在提供開箱即用的本地AI創(chuàng)作體驗(yàn)的同時(shí),深化與ISV合作伙伴的協(xié)同,為內(nèi)容創(chuàng)作者打造低門檻、低成本的高效視頻生產(chǎn)路徑。
大模型與視頻智能體支持:依托32GB顯存,銳炫Pro B70可運(yùn)行Qwen3.8-27B Q4_KM大語言模型,打開MTP,解碼速率可達(dá)52 TPS,并支持256K上下文窗口。該本地推理能力為視頻智能體搭建了堅(jiān)實(shí)的算力底座,在滿足數(shù)據(jù)隱私與離線使用的需求下,幫助企業(yè)與創(chuàng)作者有效控制運(yùn)營成本。
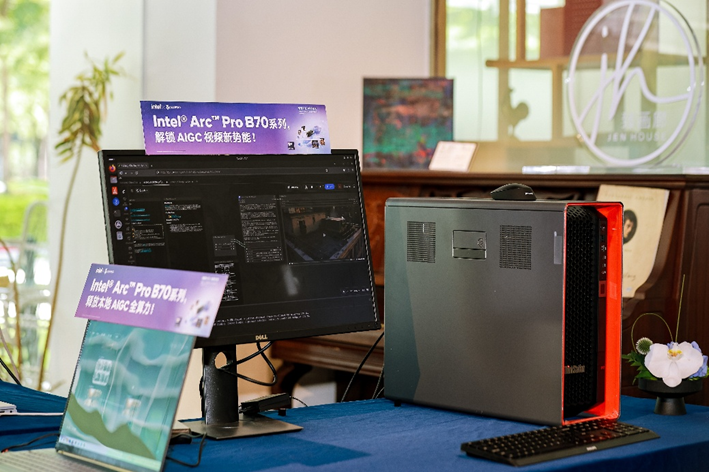
“云端+本地”混合模式,助力創(chuàng)作者高效生產(chǎn)
基于銳炫Pro B70的強(qiáng)大本地算力,創(chuàng)作者可通過“云端+本地”的混合制作模式,實(shí)現(xiàn)高效的AI視頻生產(chǎn)。在云端,創(chuàng)作者可快速探索創(chuàng)意方案;在本地,核心數(shù)字資產(chǎn)安全留存,創(chuàng)作者無需面對云端排隊(duì)與按次付費(fèi)的限制,可在畫布中自由捕捉創(chuàng)作靈感,在關(guān)鍵節(jié)點(diǎn)定制工作流,并基于本地算力訓(xùn)練出專屬的模型風(fēng)格。
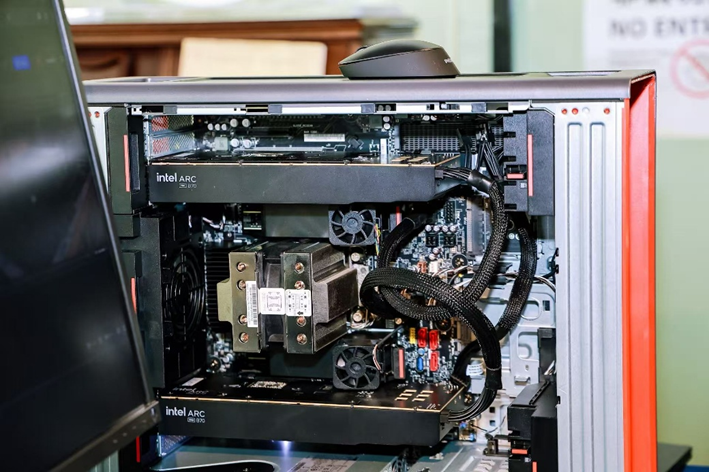
同時(shí),銳炫Pro B70還具備出色的工作站擴(kuò)展能力,可為高精度、多并發(fā)的AI推理提供強(qiáng)勁算力支撐。通過單卡、雙卡至四卡集群部署,最高可支持100B+規(guī)模的大模型推理,有效應(yīng)對影視工作室與企業(yè)級的高強(qiáng)度生產(chǎn)需求。相比按月訂閱云端算力,本地部署帶來的一次性投入具備長期成本優(yōu)勢,有助于創(chuàng)作團(tuán)隊(duì)積累專屬數(shù)字資產(chǎn)庫,減少預(yù)算對創(chuàng)作生產(chǎn)的限制。
本地化AI視頻生成工作流,進(jìn)一步釋放創(chuàng)作潛力
在實(shí)際AI視頻生產(chǎn)場景中,數(shù)字折疊依托銳炫Pro B70的硬件算力與32GB大顯存優(yōu)勢,結(jié)合MiniMax H3的開源模型能力,實(shí)現(xiàn)了視頻生成全流程的本地化運(yùn)行。
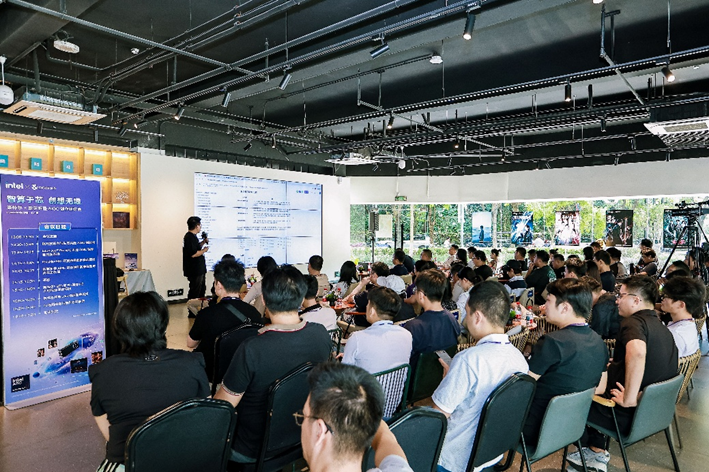
在現(xiàn)場分享環(huán)節(jié),數(shù)字折疊展示了在本地完成720P分辨率視頻的生成,并通過超分技術(shù)將畫質(zhì)提升至1080P-2K的創(chuàng)作實(shí)例。同時(shí),結(jié)合數(shù)字折疊的DFCine無限畫布工作流,傳統(tǒng)AI視頻及MV創(chuàng)作中冗長的制作鏈路,從過去的20多個(gè)節(jié)點(diǎn)縮減整合為3個(gè)核心節(jié)點(diǎn)。分鏡設(shè)計(jì)、素材生成、鏡頭控制與算力調(diào)度可呈現(xiàn)在統(tǒng)一的可視化畫布中,使創(chuàng)作者能夠通過故事板邏輯組織內(nèi)容并調(diào)用模型。
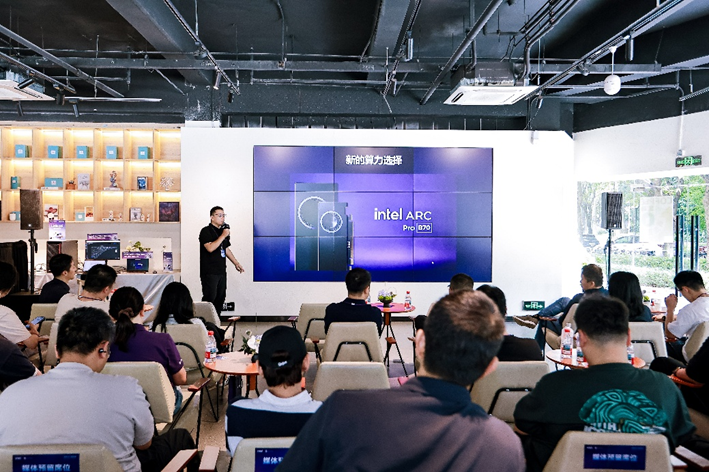
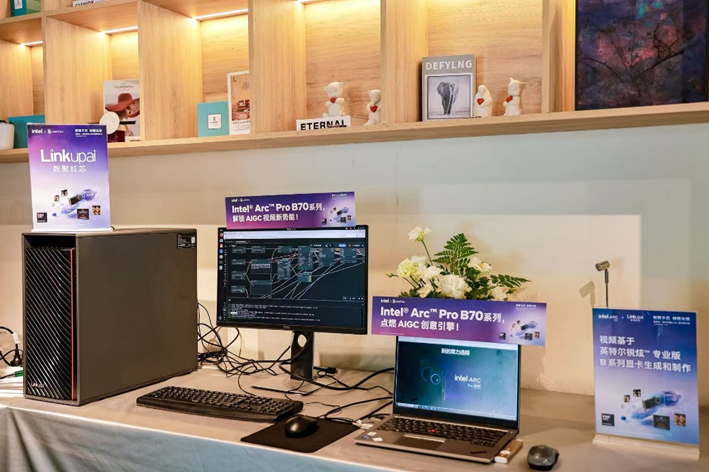
在硬件擴(kuò)展方面,該工作流不僅支持單卡高效運(yùn)行,更具備出色的擴(kuò)展性,支持多張銳炫Pro B70顯卡的并發(fā)調(diào)度,為更復(fù)雜的本地AI創(chuàng)作場景提供可擴(kuò)展的算力支撐。此外,數(shù)字折疊還展示了從“自動化啟動器—分鏡工作臺—資產(chǎn)控制臺—靈感參考—視頻生成”的下一代一體化生產(chǎn)流程,一站式實(shí)現(xiàn)從劇本分析、資產(chǎn)制作到成片交付的流程。
結(jié)論
整場研討會看下來,英特爾在AIGC視頻創(chuàng)作賽道上的思路逐漸清晰。不跟云端算力卷規(guī)模,而是用本地部署的銳炫Pro B70打性價(jià)比和靈活性——單卡能跑Qwen3 27B模型,多卡集群可以支撐100B+規(guī)模,硬件編解碼能力也足夠覆蓋專業(yè)剪輯需求。更重要的是,英特爾在軟件側(cè)下了不少功夫:MiniMax H3的Day 0適配、剪映和DaVinci的優(yōu)化、跟數(shù)字折疊一起打磨的工作流,把視頻制作從20多個(gè)節(jié)點(diǎn)壓縮到3個(gè)核心環(huán)節(jié)。這種“硬件+模型+工具鏈”的打包方式,確實(shí)降低了AI視頻創(chuàng)作的門檻。