
【導(dǎo)讀】智能會(huì)議正在成為越來(lái)越多企業(yè)的日常需求。除了穩(wěn)定、高識(shí)別率的實(shí)時(shí)轉(zhuǎn)寫(xiě),企業(yè)還希望實(shí)現(xiàn)跨語(yǔ)言翻譯和結(jié)構(gòu)化會(huì)議紀(jì)要,同時(shí)確保會(huì)議數(shù)據(jù)不出內(nèi)網(wǎng),滿足數(shù)據(jù)可靠性的要求。對(duì)于新建或既有會(huì)議室,系統(tǒng)還要易于接入,并能與企業(yè)OA等現(xiàn)有業(yè)務(wù)系統(tǒng)銜接,實(shí)現(xiàn)待辦事項(xiàng)自動(dòng)流轉(zhuǎn)。
這些需求對(duì)會(huì)議系統(tǒng)提出了更高要求。更智能的模型、更高精度的推理以及多會(huì)議室并發(fā),需要更大的顯存和更強(qiáng)的算力,也意味著更高的部署成本。英特爾與聯(lián)想要解決的,正是如何以可控成本穩(wěn)定交付一套可用、好用、可靠的智能會(huì)議系統(tǒng)。
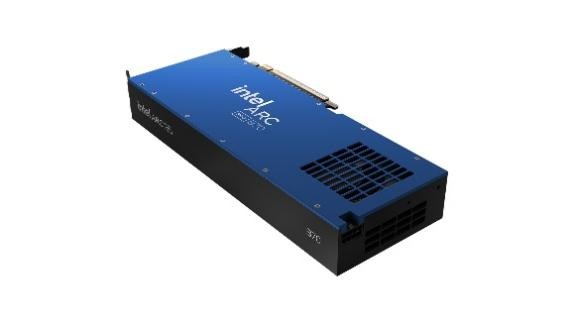
為此,英特爾與聯(lián)想聯(lián)合推出了基于英特爾銳炫? Pro B70的智能會(huì)議解決方案。32GB大顯存可承載多個(gè)大模型,高達(dá)367 TOPS的AI算力為多路實(shí)時(shí)翻譯和會(huì)議紀(jì)要快速生成提供支撐,配合入門級(jí)英特爾?酷睿? Ultra平臺(tái),為企業(yè)兼顧會(huì)議體驗(yàn)與部署成本提供了新的實(shí)現(xiàn)路徑。
英特爾中國(guó)區(qū)技術(shù)部總經(jīng)理高宇表示:“今天企業(yè)面臨的挑戰(zhàn),不僅僅是讓AI更聰明,更是讓它能夠更安全可靠地融入業(yè)務(wù)流程。英特爾正在推動(dòng)企業(yè)會(huì)議場(chǎng)景向這一需求轉(zhuǎn)變。我們期待攜手產(chǎn)業(yè)伙伴,讓更多企業(yè)能夠以更低門檻擁抱AI,把智能能力真正轉(zhuǎn)化為生產(chǎn)力。”
聯(lián)想AI工作站與工業(yè)終端營(yíng)銷總經(jīng)理陸遠(yuǎn)表示:“會(huì)議是企業(yè)知識(shí)流動(dòng)最集中的場(chǎng)景之一,也是AI最容易創(chuàng)造價(jià)值的場(chǎng)景之一。我們觀察到,越來(lái)越多的客戶希望在保護(hù)數(shù)據(jù)可靠和成本可控的同時(shí),獲得更智能的協(xié)作體驗(yàn)。聯(lián)想與英特爾攜手推出的智能會(huì)議解決方案,將切實(shí)解決多模型本地運(yùn)行難、部署成本高等痛點(diǎn),讓先進(jìn)AI進(jìn)入企業(yè)日常工作,為客戶創(chuàng)造長(zhǎng)期價(jià)值。”
解“精度與顯存平衡”瓶頸:大顯存支撐FP8量化雙模型與超長(zhǎng)會(huì)議KV緩存
一場(chǎng)智能會(huì)議可能同時(shí)涉及語(yǔ)音識(shí)別、跨語(yǔ)種實(shí)時(shí)翻譯、內(nèi)容理解和會(huì)議紀(jì)要生成,需要多個(gè)AI模型協(xié)同工作。會(huì)議時(shí)間越長(zhǎng),上下文緩存占用的顯存也越多。如何在模型精度和顯存占用之間找到平衡,成為智能會(huì)議系統(tǒng)面臨的一道現(xiàn)實(shí)難題。
在極限并發(fā)場(chǎng)景下,7B模型可支持20路會(huì)議實(shí)時(shí)翻譯,同時(shí)支持兩場(chǎng)4小時(shí)會(huì)議紀(jì)要快速生成;在這一組合并發(fā)情況下,顯存需求接近30GB 1。對(duì)于24GB或更小顯存的方案,要同時(shí)裝載多個(gè)模型和會(huì)議上下文,就需要在模型能力、推理精度與顯存占用之間做出更多取舍。
英特爾銳炫? Pro B70配備32GB顯存,可容納FP8量化的Hunyuan-MT-7B翻譯模型、Qwen3-4B會(huì)議紀(jì)要模型以及超長(zhǎng)會(huì)議所需的KV緩存。367 TOPS AI算力則為多路實(shí)時(shí)翻譯和會(huì)議紀(jì)要快速生成提供算力支撐。換句話說(shuō),大顯存讓多個(gè)模型“裝得下”,AI算力則讓模型“跑得動(dòng)”。
經(jīng)過(guò)英特爾LLM-Scaler大模型推理框架優(yōu)化,該方案可以在單卡上并行運(yùn)行Hunyuan-MT-7B與Qwen3-4B兩個(gè)模型,同時(shí)處理實(shí)時(shí)翻譯和會(huì)議紀(jì)要生成。其中,一場(chǎng)4小時(shí)會(huì)議、約6萬(wàn)字記錄的會(huì)議紀(jì)要,可在30秒內(nèi)完成生成2。
解“成本”難題:共享算力支撐多會(huì)議室并發(fā)
對(duì)于中大型企業(yè)來(lái)說(shuō),智能會(huì)議的價(jià)值不能只服務(wù)于一間會(huì)議室。如果每間會(huì)議室都單獨(dú)配置服務(wù)器,不僅意味著更高的硬件投入,也會(huì)增加日常運(yùn)維負(fù)擔(dān)。與此同時(shí),會(huì)議室數(shù)量和并發(fā)規(guī)模也會(huì)直接影響企業(yè)的算力投入。
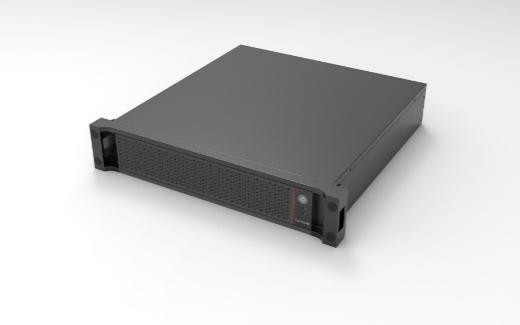
英特爾與聯(lián)想的解決思路,是依托英特爾銳炫Pro B70與入門級(jí)英特爾酷睿Ultra平臺(tái),通過(guò)后臺(tái)集中部署算力,讓多個(gè)會(huì)議空間共享AI計(jì)算資源。前端會(huì)議室按需配置輕量化采集終端,減少為不同會(huì)議空間重復(fù)配置后臺(tái)算力的需求。
在具體工作負(fù)載上,7B模型可支持20路實(shí)時(shí)翻譯并發(fā),同時(shí)支持兩場(chǎng)4小時(shí)會(huì)議紀(jì)要快速生成3。32GB顯存用于承載多個(gè)大模型,367 TOPS AI算力負(fù)責(zé)并發(fā)處理,由此在“裝得下”和“算得動(dòng)”之間實(shí)現(xiàn)兼顧。
集中式部署也讓企業(yè)可以根據(jù)會(huì)議空間的實(shí)際需求進(jìn)行配置。無(wú)論是新建會(huì)議室還是既有會(huì)議室改造,都可以按需部署前端采集終端,并由后臺(tái)統(tǒng)一提供AI算力,在會(huì)議空間擴(kuò)展和算力投入之間獲得更大的靈活性。
解“隱私”顧慮:全本地部署,讓企業(yè)用得安心
會(huì)議往往涉及企業(yè)內(nèi)部業(yè)務(wù)信息,數(shù)據(jù)可靠性因此成為智能會(huì)議落地時(shí)繞不開(kāi)的問(wèn)題。
英特爾與聯(lián)想的智能會(huì)議解決方案支持本地部署。從語(yǔ)音收集、會(huì)議轉(zhuǎn)寫(xiě)和實(shí)時(shí)翻譯,到最終紀(jì)要生成,整個(gè)過(guò)程均在企業(yè)本地環(huán)境中完成,保證全鏈路的數(shù)據(jù)可靠性。同時(shí),7×24小時(shí)連續(xù)運(yùn)行能力進(jìn)一步支撐業(yè)務(wù)連續(xù)性和穩(wěn)定性,讓企業(yè)用得既安心,又省心。
目前,該方案已在多個(gè)行業(yè)成功落地。從大顯存承載多個(gè)模型,到多路并發(fā)提升算力利用效率,從多個(gè)會(huì)議空間共享后臺(tái)算力到全流程本地部署,英特爾與聯(lián)想希望解決的并非單一的算力問(wèn)題,而是幫助企業(yè)在會(huì)議體驗(yàn)、部署成本以及數(shù)據(jù)可靠之間取得更好的平衡。
1.2.3 數(shù)據(jù)來(lái)源于英特爾實(shí)驗(yàn)室,結(jié)果可能有所不同
結(jié)論
這套英特爾與聯(lián)想聯(lián)合打造的智能會(huì)議方案,核心解決企業(yè)落地本地 AI 會(huì)議系統(tǒng)的三大痛點(diǎn):顯存不足、多會(huì)議室部署成本高、會(huì)議數(shù)據(jù)隱私風(fēng)險(xiǎn)。銳炫 Pro B70 的 32GB 大容量顯存,能夠同時(shí)裝入翻譯、紀(jì)要兩大模型,還可承載長(zhǎng)時(shí)間會(huì)議產(chǎn)生的 KV 緩存,依托 LLM-Scaler 推理框架,單卡支持多路翻譯并發(fā),長(zhǎng)會(huì)議紀(jì)要生成效率可觀。集中算力池的模式,避免每個(gè)會(huì)議室單獨(dú)配備后端服務(wù)器,降低硬件投入和運(yùn)維壓力,新舊會(huì)議室改造都能靈活適配。整套方案所有語(yǔ)音識(shí)別、翻譯、紀(jì)要生成工作都在內(nèi)網(wǎng)本地完成,滿足企業(yè)內(nèi)部敏感會(huì)議的數(shù)據(jù)安全要求。